
Windows 98でLlamaを動かした実験の答え合わせ|ローカルAIの今
2024年12月、EXO LabsがWindows 98のパソコンでLlama 2系のモデルを動かしました。実際に示されたことと、その後のローカルAIの変化、いまのパソコンでAIを動かす方法を整理します。
 著者 Jeensuk Yang
HowtoAI · ローカルAI · 答え合わせ
?この記事はこんな方に
- 「26年前のパソコンでLlama」のニュースを覚えていて、その後どうなったか知りたい方
- ChatGPTのようなAIを、インターネットにつながず自分のパソコンで動かせるか気になっている方
- 会社の資料や顧客情報を、外に出さずにAIで扱う方法を探している方
!この記事でわかること
- EXO Labsの実験で、実際に何が示されたのか(BitNetとの関係を含む)
- 2024年12月から2026年10月までに、ローカルAIで何が変わったか
- いま普通のパソコンで動かす手順と、モデルのライセンス・プライバシーの注意点
こんにちは、ヒカリです。
2025年1月に紹介した「Windows 98のパソコンでLlamaが動いた」という話の、答え合わせをします。まず実験で本当に示されたことを整理して、そのあとの約2年間の変化を見ていきますね。最後に、いまの普通のパソコンでAIを動かす方法と、使う前に知っておきたいライセンスやプライバシーの話をお伝えします。
Windows 98でLlamaを動かした実験:EXO Labsが示したこと
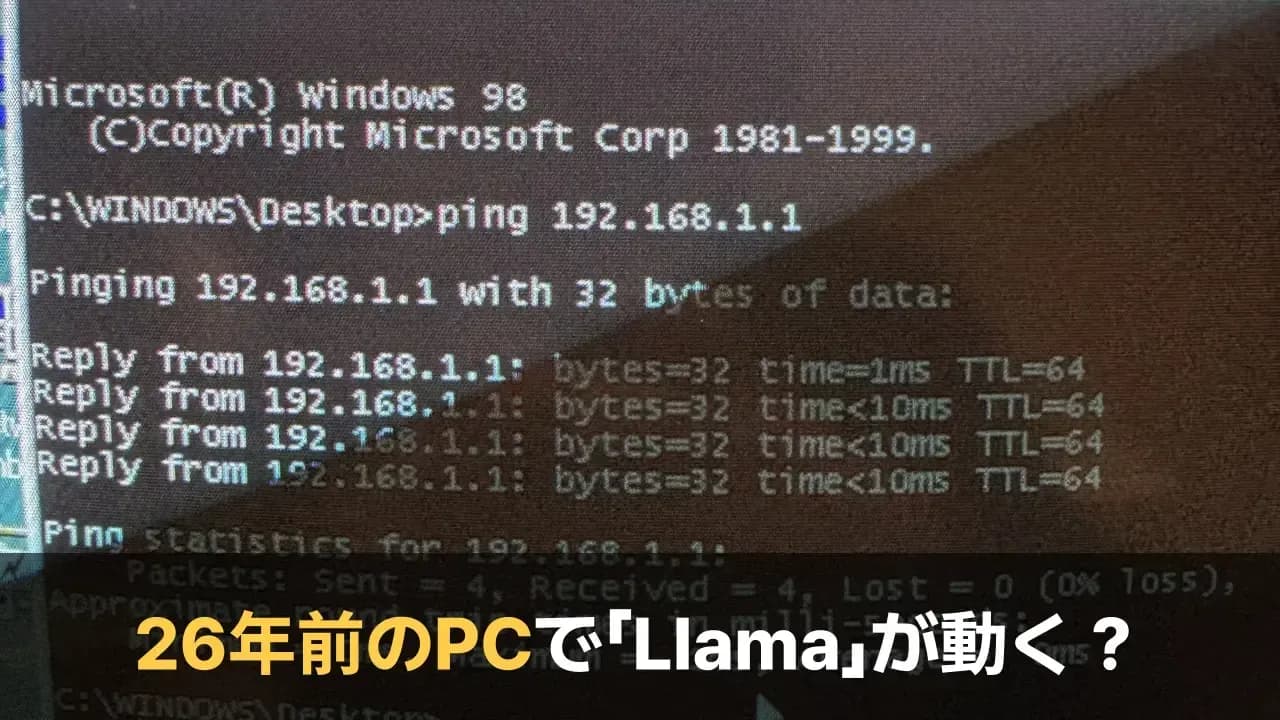
2024年12月28日、AIスタートアップのEXO Labsが、Windows 98のパソコンで大規模言語モデル(LLM)の仕組みを動かした様子をX(旧Twitter)に投稿しました。同社のブログ「12 days of EXO」の4日目の記事に、詳しい手順と数字が載っています。私たちは2025年1月、この話題を日本語で紹介しました。
EXOのブログによると、実験の中身は次のとおりです。
- パソコンはPentium IIとメモリ128MBのWindows 98機で、eBayで118.88ポンドで買った。
- ファイルはEthernet経由のFTPで、M4搭載のMacBook Proから送った。
- コンパイラの確保に苦労した。MinGWでは動かず、26年前のBorland C++ 5.02を使い、Andrej Karpathy氏の小さなC言語プログラム「llama2.c」を古い書き方に直して動かした。EXOはこれを「llama98.c」として公開している。
- GPUは使わず、CPUだけで動かした。
| モデル | パラメータ数 | 速度(トークン/秒) |
|---|---|---|
| stories260K | 26万 | 39.31 |
| stories15M | 1,500万 | 1.03 |
| Llama 3.2 1B | 10億 | 0.0093(一部の計算結果とディスク読み込みから推定した値で、最後まで動かした結果ではない) |
トークンとは、AIが文章を扱うときの単位で、おおまかに単語や記号ひとつ分です。0.0093トークン/秒は、1個を出すのに約107秒かかる速さです。実用にはなりません。この実験の価値は、「動いた」という事実を見せたことにあります。
ヒカリちゃんのまとめWindows 98で実際に動いたのは、とても小さなモデルでした。1Bの数字は推定値で、BitNetの数字は別の話だと分けて読むと、実験の姿がはっきりします。
その後の約2年:ローカルAIの年表
「ローカルAI」とは、クラウドではなく自分のパソコンの中でAIを動かすことです。2024年12月から2026年10月までの主な動きを並べます。
| 時期 | 出来事 |
|---|---|
| 2024年12月28日 | EXO LabsがWindows 98での実験をXに投稿。 |
| 2025年2月18日 | Microsoftが、BitNetをCPUで動かす推論ソフト「bitnet.cpp」の論文を公開。 |
| 2025年4月 | Meta「Llama 4」が登場。マルチモーダルのモデルについて、EU拠点の企業・個人には権利を認めないライセンスが話題になった。 |
| 2025年4月14日 | Microsoftが、初の公式BitNetモデル「BitNet-b1.58-2B-4T」(24億パラメータ、4兆トークンで学習)をHugging Faceで公開。 |
| 2025年5月 | Microsoftが、Windowsでローカルにモデルを動かす「Foundry Local」を発表。20日にはBitNetのGPU向け公式カーネルも公開。 |
| 2025年7月8日 | ローカルAIアプリ「LM Studio」が、仕事での利用に別途の商用ライセンスを不要にした。 |
| 2025年8月5日 | (米国時間。日本では6日に報道)OpenAIがオープンウェイトモデル「gpt-oss-120b」「gpt-oss-20b」をApache 2.0ライセンスで公開。20bは16GBのメモリで動くとされた。 |
| 2026年1月15日 | bitnet.cppにCPU向けの最適化。追加で1.15〜2.1倍の高速化と報告。 |
| 2026年4月2日 | Googleが「Gemma 4」を公開。ライセンスがApache 2.0になった。小さいE2B・E4Bはスマホやラズパイ向け。 |
| 2026年4月9日 | Microsoftが「Foundry Local」の一般提供を開始。Windows、Apple Silicon搭載Mac、Linuxで使える。 |
| 2026年7月 | BitNet関連で、1ビットの埋め込みモデルやCPU向け音声認識エンジン「VibeASR.cpp」を公開。 |
EXO Labs自身は、古いパソコンの実験から、複数のパソコンやMacをつないで大きなモデルを動かすソフト「exo」の開発に軸足を移しているようです。2026年4月のレビュー記事によると、現在のREADMEは自動の機器検出やThunderbolt 5によるメモリ共有などを掲げています。同社の求人では「1台のMacBookから数千台のクラスターまで」とうたっています。
2024年12月のころ、ローカルで動くAIといえば、性能が限られた小さなモデルが中心でした。いまは、OpenAIのgpt-oss、GoogleのGemma 4、AlibabaのQwen3のように、大きな会社が商用利用できるライセンスで中くらいのモデルを公開しています。EXOの実験が示した「大きな設備がなくてもAIは動く」という考えは、小さなモデルを賢くする競争として広がった、と見ることができます。
ヒカリちゃんのまとめこの約2年で、小さなモデルが賢くなり、無料のアプリで動かせるようになりました。ローカルAIは、実験から日常の道具に近づいています。
2025年の記事の答え合わせ
2025年1月の記事に書いた内容を、EXOのブログなどの元の資料と、その後の動きに照らして確かめます。
| 当時書いたこと | いま振り返ると | 判定 |
|---|---|---|
| 26年前のPentium II・Windows 98のパソコンで、Llama 2系のモデルが動いた | EXOのブログで確認できる。動いたのは、Llama 2の仕組みを使った小さなモデル。 | 当たり |
| 260Kモデルは毎秒約36個、15Mモデルは毎秒約1個 | EXOのブログでは39.31と1.03。36という数字は元の資料と合っていない。 | 半分当たり |
| Llama 3.2の1Bモデルは毎秒0.0093個 | 数字は元の資料どおり。ただし推定値であることを書いていなかった。 | 半分当たり |
| BitNetはEXO Labsが開発した技術 | BitNetはMicrosoftの技術で、公式の推論ソフトbitnet.cppもMicrosoftが公開している。EXOは解説していたにすぎない。 | 外れ |
| BitNetなら7Bモデルが約1.38GB、100BモデルがCPUで毎秒5〜7トークン | 数字自体は資料にある。ただ、公開された公式モデルは約24億パラメータの「2B4T」で、100Bは確認できていない。 | 半分当たり |
| 高価なGPUがなくてもAIを動かせる未来が来る | gpt-oss-20bは16GBのメモリで動く。Gemma 4の小型版はスマホ向け。方向は合っていた。 | 当たり |
| 古いパソコンでも小さなモデルなら動く(だから誰でも使える) | 動くことと、仕事で使えることは別だった。実用の目安は、いまのパソコンと、動かすモデルの大きさ。 | 半分当たり |
いちばんの見落としは、「動いた」と「使える」を分けて書かなかったことです。
当時の記事は、実験の面白さと可能性を伝えることに重きを置きました。けれど読者にとって大事なのは、自分のパソコンで何が動くのか、権利は大丈夫か、データは外に出ないのか、でした。このあとの3つの章は、その点を補うために書きました。
ヒカリちゃんのまとめ実験そのものと「GPUがなくても動く」という方向は当たっていました。外れたのはBitNetの開発元で、足りなかったのは「使える条件」の説明でした。
パソコンでローカルAIを動かす方法:Ollama・LM Studio
普通のWindowsパソコンやMacで、ローカルAIを始める手順を紹介します。無料のアプリが2つあり、どちらもWindows・macOSで使えます。
画面を見ながらモデルを探してダウンロードし、チャットできるアプリです。2025年7月から、仕事での利用に別の商用ライセンスは要りません。初めての方はこちらが向いています。
コマンド(命令文)でモデルを動かすソフトです。Windows、macOS、Linuxに対応します。公式ページには「ollama run gemma4」のように1行で起動する例があります。
Microsoftのローカル実行基盤です。アプリに組み込む前提で、開発者向けのSDKが中心です。アプリ側が使っている場合もあります。
LM Studioで始める手順
- 公式サイト(lmstudio.ai)からアプリをダウンロードして、インストールする
- アプリ内でモデルを検索し、パソコンのメモリに収まる大きさのモデルを選んでダウンロードする
- ダウンロードしたモデルを読み込み、チャット画面で日本語で話しかける
- 最初の回答が出たら、Wi-Fiを切っても動くか試してみる(動けば、クラウドを使っていない目印になります)
どのくらいのパソコンが必要か
モデルは、メモリ(Macではユニファイドメモリ、WindowsではRAMやGPUのVRAM)に入りきる大きさが目安です。おおまかな計算として、モデルのファイルの大きさは「パラメータ数 × 1つあたりのビット数 ÷ 8」です。たとえば70億パラメータのモデルを4ビットに圧縮すると約3.5GB、BitNetの1.58ビットなら約1.4GBです。EXOのブログの「7Bで1.38GB」とも合います。実際には、このほかに作業用のメモリも必要です。
| 目的 | 目安 |
|---|---|
| まず試す | 数十億パラメータの小さなモデル。Gemma 4のE2B・E4Bは、スマホやラズパイ向けとして公開されている。 |
| 仕事の下書き・要約 | gpt-oss-20bは、OpenAIの説明で16GBのメモリを搭載した機器で動くとされる。メモリ16GB以上のパソコンが出発点。 |
| 大きなモデル | gpt-oss-120bは単一の80GB GPUが前提。個人のパソコンでは難しい。 |
動かしてみると、まず速度に驚くかもしれません。クラウドのChatGPTのように、すぐに長い文章は出てきません。メモリに収まる範囲でも、GPUがないパソコンでは1文字ずつ表示されるような速さになることがあります。その場合は、ひとつ小さいモデルに変えると、たいてい楽になります。また、ローカルのモデルは、最新のニュースを知りません。最新の情報が必要な作業は、クラウドのAIや検索と使い分けてください。
ヒカリちゃんのまとめまずはLM Studioを入れて、小さなモデルで試してみてください。メモリが16GBあれば、gpt-oss-20bも視野に入ります。
ローカルAIのモデルのライセンスと、仕事で使うときの注意
ローカルAIのモデルは、無料で手に入ります。けれど、「無料」と「仕事で自由に使える」は同じではありません。モデルごとにライセンスが違うので、仕事で使う前に確かめてください。
| モデル | ライセンス | 仕事で使うときの注意 |
|---|---|---|
| gpt-oss(OpenAI) | Apache 2.0 | 商用利用と再配布が認められている。 |
| Gemma 4(Google) | Apache 2.0(Gemma 4から) | 以前は独自のライセンスだったが、Gemma 4で変わった。古いGemmaを使う場合は、そのモデルの条件を別に確認する。 |
| Qwen3(Alibaba) | Apache 2.0 | Qwen3の公式ブログで、オープンウェイトのモデルはApache 2.0とされている。 |
| Llama 4(Meta) | Llama 4 Community License | 月間ユーザーが7億人を超える企業は別途ライセンスが必要。「Built with Llama」の表示などの条件がある。マルチモーダルのモデルは、EU拠点の企業・個人に対する権利が限られる。 |
| BitNet(Microsoft) | MIT(bitnet.cppのリポジトリ) | モデルごとの条件は、公開ページで確認する。 |
ライセンスは、モデルの「使い方」を決めるものです。モデルが書いた文章や画像に他人の著作物が似てしまう可能性は、別の問題として残ります。ローカルで動かしても、出力を確認する手間は変わりません。社外に出す資料に使う前に、数字・固有名詞・引用を元の資料で確かめてください。
ライセンスの条文は、日本の法律の観点でも判断が分かれることがあります。契約や大きな案件に使うときは、専門家に相談するのが安全です。
ヒカリちゃんのまとめ仕事で使うなら、モデルのライセンスを先に見る習慣をつけましょう。Apache 2.0なら制限が少なく、Llamaには企業向けの条件があります。
ローカルAIのプライバシーと、AIパソコン(NPU)の選び方
ローカルAIのいちばんの利点は、入力した文章がパソコンの外に出ないことです。顧客の名前や見積もり、社内の議事録のように、クラウドのサービスには入れにくい文章を扱うときに役立ちます。LM Studioは、公式ブログで「家でも職場でも無料」と案内し、プライバシーポリシーは変えないとしています。
- ネットを切って動くか確かめる。回答が出れば、文章はパソコンの中で処理されています
- 「クラウド」のモデルを選ばない。Ollamaなどには、クラウドで動くモデルも並びます。名前に「cloud」と付くものは外に送られます
- 社内ルールを確認する。ローカルで動かしても、どのソフトを入れてよいかは会社が決めることがあります
- 履歴の保存先に気をつける。アプリはチャットの履歴をパソコンに残すことがあります。共有のパソコンでは削除の方法を確認します
EXOの実験が教えてくれるのは、AIの性能が「何を動かすか」だけでなく「どこで動かすか」にも左右される、ということです。クラウドは手軽で強力ですが、データを預けることになります。手元のAIは小さい分だけ力は劣りますが、情報を預けずに済みます。扱う情報の重さに合わせて、2つを使い分けるのが現実的です。
AIパソコン(Copilot+ PC)は必要か
Copilot+ PCは、毎秒40兆回以上の演算ができる(40 TOPS以上の)NPUを積んだWindows 11のパソコンで、条件としてメモリ16GBとストレージ256GBが挙げられています。メモ帳やペイントなどの機能が、パソコンの中で動きます。くわしくは Windows 11のAI機能の記事 にまとめています。
ここまで紹介したOllamaやLM Studioは、NPUがなくても使えます。まずは今あるパソコンで試し、メモリが足りないと感じたら買い替えを考える、という順番で十分です。パソコンを買うなら、モデルの大きさに直結するメモリの量を最優先で見てください。ChatGPTなどクラウドのAIとの使い分けは、ChatGPTのモデルの違いの記事 が参考になります。
ヒカリちゃんのまとめローカルAIは、文章を外に出さずに使えるのが強みです。まずは今のパソコンで試して、足りなければメモリを重視して選んでくださいね。
ローカルAI・EXO Labsについてよくある質問
Windows 98のパソコンで、いまもChatGPTのようなAIは使えますか?
使えません。EXO Labsが動かしたのは、物語を作る程度の小さなモデルです。Llama 3.2の1Bモデルでも、推定で毎秒0.0093トークンでした。
BitNetとは何ですか?
モデルの重みを3つの値(-1、0、1)で表し、計算を軽くする仕組みです。Microsoftが公式の推論ソフトbitnet.cppと、約24億パラメータのモデルを公開しています。
ローカルAIは、仕事で使っても安全ですか?
入力した文章が外に出ない点では、クラウドより安全です。ただし、モデルのライセンスと、出力の正確さの確認は別に必要です。会社のルールも先に確かめてください。
ローカルAIを動かすのに、GPUは必要ですか?
必須ではありません。CPUとメモリだけでも動きますが、速度はGPUがあるほうが出ます。メモリが足りないと、大きなモデルは読み込めません。
SOURCES
- EXO Labs「Running LLMs on Windows 98」(12 days of EXO 4日目)(2026年10月26日確認) blog.exolabs.net/day-4
- EXO Labs(@exolabs)のX投稿(2024年12月28日) x.com/exolabs/status/1873103218596811059
- Microsoft「BitNet(bitnet.cpp)」GitHubリポジトリ(2026年10月26日確認) github.com/microsoft/BitNet
- Impress Watch「OpenAI、オープンウェイトのAIモデル「gpt-oss」を公開」(2025年8月6日) watch.impress.co.jp/docs/news/2037179.html
- GIGAZINE(2025年8月6日) gigazine.net/news/20250806-openai-gpt-oss
- 9to5Google「Google Gemma 4」(2026年4月2日) 9to5google.com/2026/04/02/google-gemma-4
- The Decoder「Gemma 4 is now available with Apache 2.0 licensing for the first time」(2026年4月) the-decoder.com
- Qwen「Qwen3」公式ブログ qwenlm.github.io/blog/qwen3
- The Decoder「Meta releases first multimodal Llama 4 models, leaves EU out in the cold」(2025年4月) the-decoder.com
- Meta「Llama FAQ」(2026年10月26日確認) developer.meta.com/ai/faq
- LM Studio「LM Studio is free for use at work」(2025年7月8日) lmstudio.ai/blog/free-for-work
- Ollama ダウンロードページ(2026年10月26日確認) ollama.com/download
- Ollama GitHubリポジトリ(2026年10月26日確認) github.com/ollama/ollama
- Microsoft Foundry Blog「Foundry Local is generally available」(2026年4月9日) devblogs.microsoft.com/foundry/foundry-local-ga
- TechCrunch「Microsoft gives its AI dev tools for Windows a fresh coat of paint」(2025年5月19日) techcrunch.com
- EXO レビュー記事(2026年4月2日) aicoolies.com/reviews/exo-review
- EXO Labs 求人ページ(2026年10月26日確認) team.exolabs.net/founding-researcher
「HowtoAI」は、2024年から multifverse.com で続けてきたAI活用の解説シリーズです。社名があたたかいデジタル(ATATAKAI Digital)に変わったことにともない、2026年10月からはこのブログの一つのカテゴリーとして続けていきます。これからもどうぞよろしくお願いいたします。
最終更新 2026年10月26日