Llama 3.1 다시 보기: 오픈소스의 의미와 그 뒤
2024년 7월에 발표된 Meta의 「Llama 3.1」을 2026년 10월의 눈으로 다시 살펴봅니다. 「오픈소스」라고 부를 수 있는지, Llama 4에서 Muse로의 방침 전환, 라이선스의 제한, 지금 한국에서 쓸 수 있는 오픈 웨이트 모델까지 정리합니다.
 글쓴이 Jeensuk Yang
HowtoAI · 오픈 웨이트 AI · 다시 보기
?이런 분께 권합니다
- 「Llama 3.1」 소식을 기억하고, 그 뒤가 어떻게 되었는지 궁금한 분
- 「오픈소스 AI」라는 말을 듣고 상업적으로 자유롭게 쓸 수 있다고 생각한 분
- Llama나 비슷한 모델을 업무에 안전하게 쓸 수 있는지 확인하고 싶은 분
!이 글에서 알 수 있는 것
- Llama 3.1의 발표 내용, 그리고 2024년 글에서 무엇이 맞고 무엇이 틀렸는지
- Llama 4에서 2026년 10월의 「Muse」까지, Meta의 방침이 어떻게 움직였는지
- 라이선스의 제한, 그리고 지금 한국에서 쓸 수 있는 오픈 웨이트 모델
안녕하세요, 히카리예요.
2024년 7월에 소개한 「Llama 3.1」을 다시 살펴볼게요. 먼저 당시 발표에서 무슨 말이 나왔는지 정리하고, 그 뒤 2년 남짓 Meta와 Llama가 어떻게 달라졌는지 볼게요. 그다음 「오픈소스」라는 말과 라이선스 이야기로 넘어가고, 마지막으로 지금 한국에서 쓸 수 있는 선택지를 알려 드릴게요.
Llama 3.1이란: 2024년 7월의 발표 내용
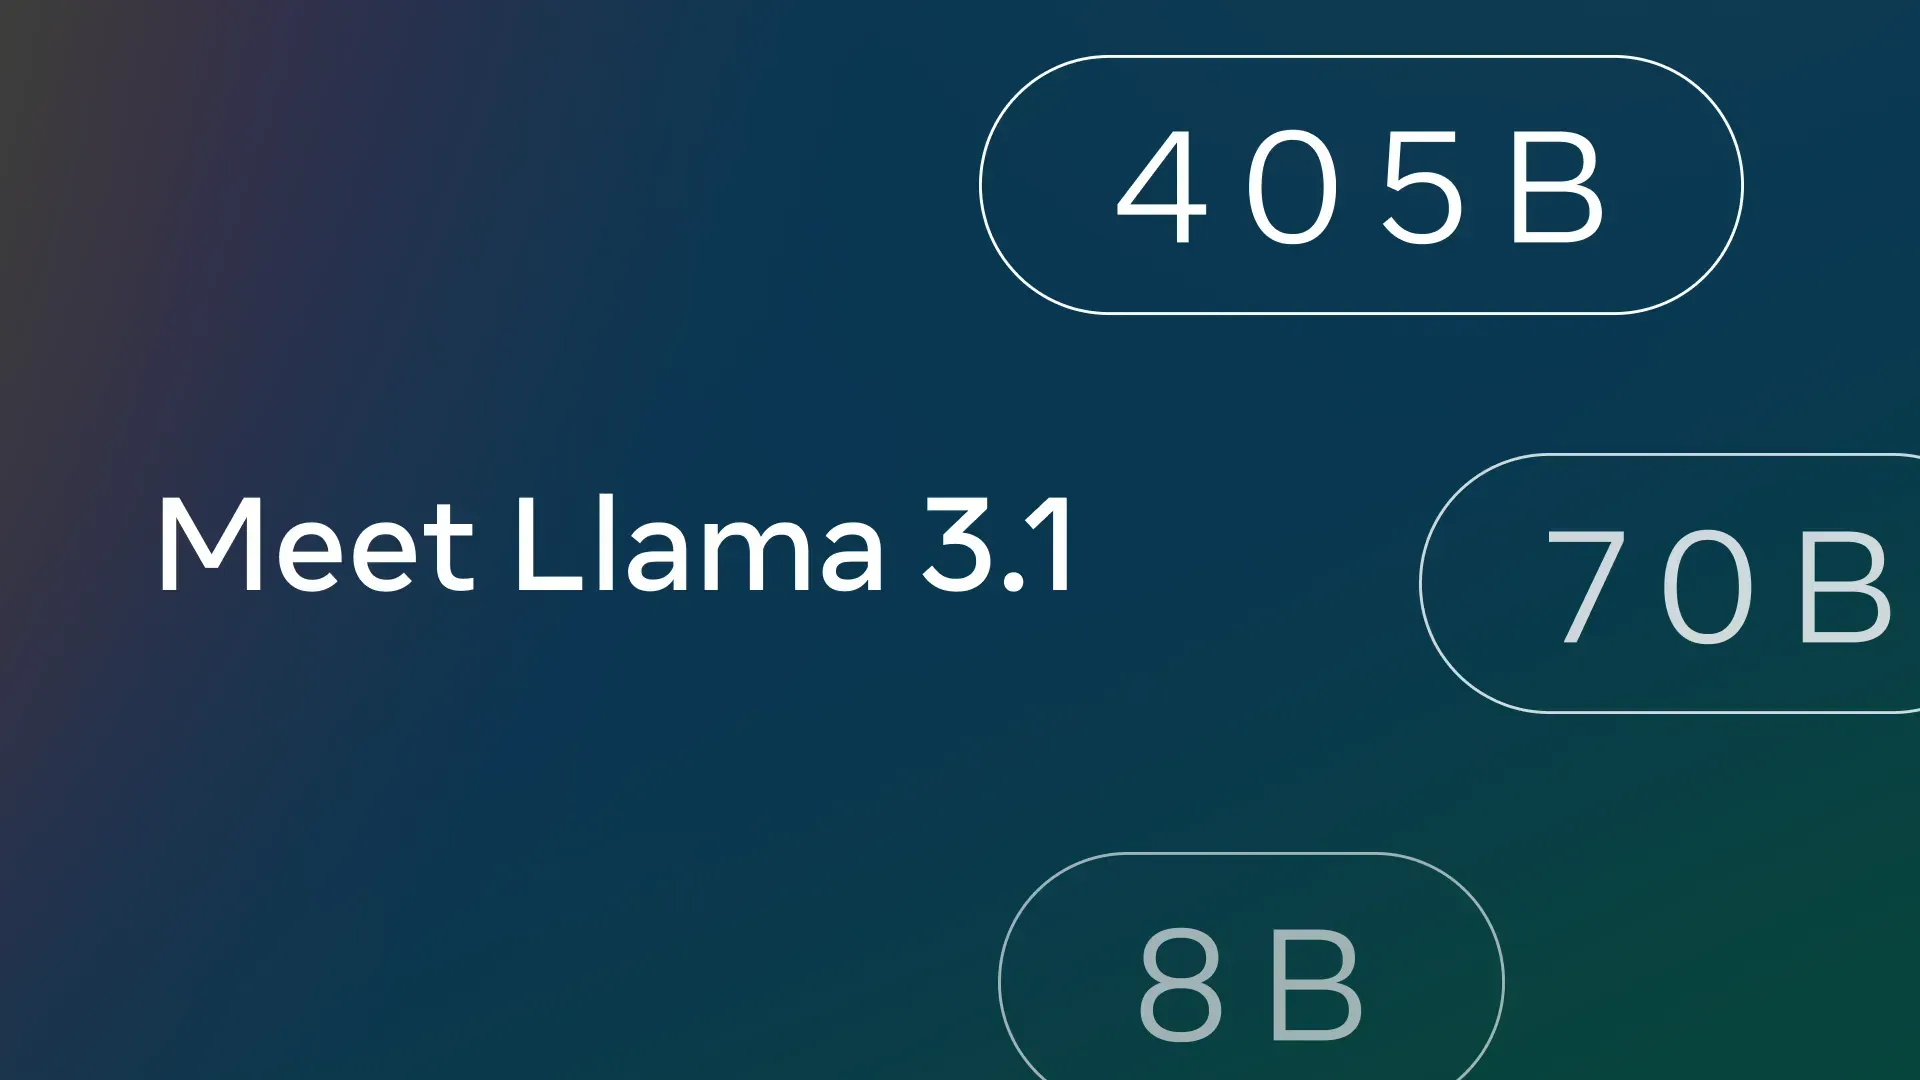
Meta는 2024년 7월 23일 AI 모델의 새 세대 「Llama 3.1」을 공개했습니다. 8B, 70B, 405B 세 가지 크기가 있고, 가장 큰 405B(4,050억 파라미터)를 Meta는 「최초의 최첨단급 오픈소스 AI 모델」이라고 소개했습니다. 저희는 같은 달에 이 발표를 일본어로 기사화했습니다.
당시 발표의 요점은 다음과 같습니다.
- 성능: Meta는 150개가 넘는 벤치마크와 사람 평가를 거쳐, 405B가 GPT-4o, Claude 3.5 Sonnet과 겨룰 만한 수준이라고 설명했습니다. 모델 카드 수치로 405B Instruct의 MMLU(CoT)는 88.6입니다.
- 지원 언어: 영어, 독일어, 프랑스어, 이탈리아어, 포르투갈어, 힌디어, 스페인어, 태국어의 8개 언어입니다. 한국어는 공식 지원 언어에 들어 있지 않습니다.
- 라이선스 변경: 모델의 출력을 다른 모델을 개선하는 데 쓸 수 있게 되었습니다. 합성 데이터 생성과 「증류」(큰 모델의 답으로 작은 모델을 키우는 것)가 목적입니다.
- 파트너: AWS, NVIDIA, Databricks, Groq, Dell, Azure, Google Cloud, Snowflake 등 25개 이상 회사가 첫날부터 서비스를 준비했습니다.
학습 규모에 대해 보도는 NVIDIA H100 약 1만 6,000개를 썼다고 전했습니다. Meta의 모델 카드에 따르면 학습에 든 계산량은 전체 3,930만 GPU 시간이고, 이 중 405B가 3,084만 GPU 시간입니다.
히카리짱의 정리Llama 3.1은 가중치를 공개한 큰 모델로서 분명 큰 사건이었어요. 다만 한국어가 공식 지원 언어에 없었다는 점은 기억해 두세요.
그 뒤의 연표: Llama 4에서 Muse로
2024년 7월부터 2026년 10월까지, Meta의 오픈 웨이트(가중치를 공개하는) 모델을 둘러싼 주요 움직임입니다.
| 시기 | 사건 |
|---|---|
| 2024년 7월 23일 | Llama 3.1(8B·70B·405B) 공개. |
| 2024년 10월 | OSI(Open Source Initiative)가 「오픈소스 AI 정의」 1.0을 공개. Meta의 Llama는 학습 데이터가 공개되지 않은 점 등으로 이 정의를 충족하지 못한다고 보도되었다. 일본에서는 도쿄과학대학과 AIST 팀이 Llama 3.1의 일본어를 강화한 「Llama 3.1 Swallow」를 공개했다(10월 8일). |
| 2025년 2월 18일 | OSI가 Llama의 라이선스는 오픈소스가 아니라고 다시 밝힘. |
| 2025년 4월 5일 | Llama 4의 Scout와 Maverick 공개. 이미지와 텍스트를 다루며, 라이선스는 Llama 4 Community License. 가장 큰 Behemoth는 당시 학습 중이라 공개되지 않았다. |
| 2025년 6월 | Meta가 Scale AI 지분 49%를 143억 달러에 인수하고, 공동 창업자 Alexandr Wang이 최고 AI 책임자에 취임. 이후 Meta Superintelligence Labs(MSL)가 새 AI 개발의 중심이 된다. |
| 2026년 4월 8일 | MSL의 첫 모델 「Muse Spark」 발표. 가중치를 공개하지 않는 독자(프로프라이어터리) 모델로, Meta AI 앱과 웹에서 쓸 수 있다. Meta는 「현재의 Llama 모델은 오픈소스로 계속 쓸 수 있다」고 했지만, 새 Llama를 만들지는 밝히지 않았다. |
| 2026년 8월 10일 | 소형 오픈 웨이트 모델 「Muse Glimmer」 공개. 보도에 따르면 약 300억 파라미터, Apache 2.0이며 Muse Spark 1.2를 증류한 것. 노트북이나 GPU 한 장에서 돌리는 것이 목표(Meta 자체 페이지에서는 확인하지 못함). |
| 2026년 10월 15일 | 「Muse Spark Open」 공개. 816B 파라미터(실제로 동작하는 것은 42B), 컨텍스트 길이 100만 토큰, Hugging Face에서 가중치 배포. 라이선스는 독자적인 「Muse Model License」. |
흐름을 한마디로 하면, Meta는 「Llama를 계속 공개하는 회사」에서 「독자 모델을 주역으로 삼으면서 다른 이름으로 가중치도 내놓는 회사」로 바뀌었습니다. Meta는 Llama 4 다음으로 Llama라는 이름의 새 세대를 내지 않았습니다. 2026년 10월 26일 시점에 저희가 확인한 Llama의 최신판은 2025년의 Llama 4입니다.
히카리짱의 정리Llama 다음에 나온 것은 Llama 5가 아니라 Muse라는 새 이름의 모델 가족이었어요. 가중치 공개는 이어지고 있지만, 주역은 가중치를 공개하지 않는 독자 모델로 옮겨 갔어요.
2024년 글 다시 보기
2024년 7월 글에 쓴 내용을 지금 시점의 공식 자료와 맞춰 확인합니다.
| 당시 쓴 것 | 지금 돌아보면 | 판정 |
|---|---|---|
| 역대 최대의 「오픈소스」 AI 모델 | 공개 당시 가중치를 공개한 모델로는 최대급이었다. 지금은 Muse Spark Open(816B)이나 Llama 4 Maverick(총 파라미터 400B) 등이 있어 405B가 최대는 아니다. 또 「오픈소스」라는 호칭은 OSI가 인정하지 않는다. | 반쯤 맞음 |
| 8개 언어 지원(아랍어, 벵골어 포함) | 공식 8개 언어는 영어·독일어·프랑스어·이탈리아어·포르투갈어·힌디어·스페인어·태국어. 아랍어와 벵골어는 없다. 한국어도 없다. | 틀림 |
| 15조 토큰 이상으로 학습, 컨텍스트는 12만 8,000 토큰 | 모델 카드의 기재와 일치한다. | 당시엔 정확 |
| MMLU 88.6% | 405B Instruct의 MMLU(CoT)는 모델 카드에서도 88.6. GPT-4o의 88.7%라는 비교 상대 수치는 이번에 확인하지 않았다. | 맞음 |
| NVIDIA H100 1만 6,000개로 학습 | 보도에서도 약 1만 6,000개로 전해졌다. | 맞음 |
| 사용 비용은 GPT-4o의 절반 | 저커버그 씨의 공개 서한(2024년 7월 23일)에 405B를 자체 환경에서 돌리는 비용이 「GPT-4o 같은 비공개 모델의 약 50%」라고 적혀 있었다. Meta 블로그 본문이 아니라 서한의 서술이며, 제3자의 검증은 확인하지 못했다. | 반쯤 맞음 |
| 상업용 라이선스의 세부 내용은 아직 불명 | 라이선스 전문은 공개일인 2024년 7월 23일 자로 이미 나와 있었다. 월간 이용자 7억 명 조건이나 표기 의무 등이 분명하게 적혀 있다. | 지금은 다름 |
| 내년에는 Llama가 업계에서 가장 앞선 모델이 된다(저커버그 씨) | Llama 4 뒤에 Meta는 새 조직 MSL에서 독자 모델 Muse Spark를 만들었다. Meta는 Muse Spark가 Llama 4 Maverick과 같은 힘을 10배 넘게 적은 학습 계산량으로 냈다고 설명한다. | 틀림 |
가장 큰 놓침은 「오픈소스」를 Meta의 말 그대로 쓴 것입니다.
제목에도 본문에도 Meta의 설명을 그대로 썼습니다. 하지만 그 말이 무엇을 약속하는지는 확인하지 않았습니다. 다음 장에서 정리합니다.
히카리짱의 정리숫자 부분은 대체로 맞았어요. 틀린 것은 언어 목록과 「오픈소스」라는 호칭, 그리고 Llama의 앞날에 대한 전망이었어요.
Llama는 「오픈소스」인가: 라이선스의 제한
「오픈소스」는 정해진 의미를 가진 말입니다. OSI의 「오픈소스 정의」는 누구에게나, 어떤 분야에서도 제한 없이 쓸 수 있을 것을 요구합니다. AI용 정의 1.0은 여기에 네 가지 자유를 더합니다. 쓰고, 살펴보고, 바꾸고, 공유하는 자유입니다. 그리고 학습 데이터 정보, 학습과 실행 코드, 가중치를 OSI가 인정하는 조건으로 공개할 것을 요구합니다.
OSI는 2025년 2월 Llama의 라이선스는 오픈소스가 아니라고 다시 밝혔습니다. 이유는 특정한 사람이나 용도를 차별하거나 분야를 제한하기 때문입니다. 새 버전에는 EU 사람을 쓸 수 없게 하는 제한도 더해졌다고 지적합니다.
Llama 3.1의 라이선스 본문에서 업무에 쓸 때 관련되는 조건을 골랐습니다.
| 조건 | 내용(Llama 3.1) |
|---|---|
| 월간 이용자 7억 명 | 자사와 관련 회사 제품의 월간 이용자가 2024년 7월 23일 시점의 전월에 7억 명을 넘었다면 Meta에서 라이선스를 받아야 한다. Meta는 허락하지 않을 자유도 가진다. |
| 「Built with Llama」 | Llama의 소재나 파생물, 그것을 포함한 제품을 배포할 때는 관련 웹사이트나 화면 등에 이 표기를 눈에 띄게 낸다. |
| 이름 붙이는 법 | Llama나 그 출력을 써서 배포할 AI 모델을 만들거나 개선했다면 그 모델의 이름은 「Llama」로 시작한다. |
| 이용 규정 | 법령을 따르고, Meta의 이용 규정(Acceptable Use Policy)을 따른다. |
대부분의 작은 회사에는 7억 명 조건이 해당하지 않습니다. 실제로 신경 쓸 것은 표기 의무, 이름 붙이는 법, 이용 규정입니다.
Llama 4의 라이선스는 다른 문서입니다. 월간 이용자 7억 명을 넘는 기업이 별도 라이선스를 받아야 한다는 점과 「Built with Llama」 표시는 Llama 4에서도 이어집니다. 더해서 이미지도 다루는 멀티모달 모델은 EU에 거점이 있는 기업이나 개인에 대한 권리가 제한됩니다. 한국 회사에는 직접 관련이 없지만, EU 거래처에 납품하는 시스템이라면 영향이 있을 수 있습니다.
라이선스는 모델을 어떻게 쓸지를 정하는 것입니다. 모델이 쓴 글이나 이미지가 타인의 저작물과 비슷해질 가능성은 라이선스와 별개의 문제로 남습니다. 한국에서는 2026년 1월 22일부터 「인공지능기본법」(정식 명칭은 「인공지능 발전과 신뢰 기반 조성 등에 관한 기본법」)이 시행되었습니다. 과학기술정보통신부는 현장에 안착시키기 위해 최소 1년 이상 규제를 유예한다는 방침을 밝혔습니다. 자사 서비스에 생성형 AI를 넣는 경우에는 어떤 의무가 해당하는지 법령 원문으로 확인하세요. 외부에 내는 글은 반드시 사람이 확인하고, 계약이나 큰 건에 쓸 때는 전문가와 상의하면 안전합니다.
히카리짱의 정리Llama는 가중치가 공개되어 있어도 OSI 정의로는 「오픈소스」가 아니에요. 쓰기 전에 라이선스 조건을 읽는 것이 가장 중요해요.
Llama 등 오픈 웨이트 모델 사용법
지금 한국에서 시험해 본다면 방법은 크게 두 가지입니다. 내 컴퓨터에서 돌리는 방법과 클라우드 서비스를 거쳐 쓰는 방법입니다.
내 컴퓨터에서 돌리기
순서와 필요한 메모리 기준은 Windows 98 실험 글에 정리했습니다. 여기서는 Llama 3.1에 한정해 보충합니다. Ollama 라이브러리에서는 다음 세 가지 크기가 배포되고 있습니다.
| 이름 | 다운로드 크기 | 기준 |
|---|---|---|
| llama3.1:8b | 4.9GB | 보통 컴퓨터에서 시험할 수 있다. 「ollama run llama3.1」로 실행한다. |
| llama3.1:70b | 43GB | 큰 메모리가 필요하다. 개인 컴퓨터에는 무겁다. |
| llama3.1:405b | 243GB | 개인 컴퓨터에서는 현실적이지 않다. |
제목에 나온 405B는 손안에서 돌리는 모델이 아닙니다. 업무에서 시험한다면 먼저 8B입니다. 다만 Llama 3.1은 한국어가 공식 지원 언어에 들어 있지 않습니다. 한국어 문서를 다룬다면 한국어를 공식 지원하는 모델을 함께 비교해 보는 편이 좋습니다.
한국에서 만든 오픈 웨이트 모델
한국 기업의 모델도 가중치가 공개되어 있습니다. LG AI연구원은 2026년 7월 31일 「K-EXAONE 2.0」(총 750B 파라미터)을 Hugging Face에 공개했고, 라이선스를 Apache 2.0으로 바꿨다고 밝혔습니다. 한국어를 포함한 10개 언어를 지원하며, 과학기술정보통신부의 독자 AI 파운데이션 모델 프로젝트의 두 번째 모델입니다. 다만 이 크기는 개인 컴퓨터에서 돌리는 모델이 아닙니다. 네이버클라우드는 2025년 4월 「HyperCLOVA X SEED」 경량 모델 3종(3B·1.5B·0.5B)을 상업 이용이 가능한 오픈소스로 공개했습니다. 이쪽은 작아서 시험하기 쉽지만, 정확한 라이선스 이름은 모델 카드에서 직접 확인하세요.
Llama에 얽매이지 않는다면
지금은 상업적으로 쓰기 쉬운 라이선스의 모델이 늘었습니다. 내용은 Windows 98 글에 실은 것과 같습니다.
2025년 8월 공개. 20b는 16GB 메모리에서 돌아간다고 설명되어 있습니다.
2026년 4월 공개. 작은 E2B·E4B는 스마트폰이나 라즈베리 파이용입니다.
공식 블로그에서 오픈 웨이트 모델은 Apache 2.0이라고 밝혔습니다.
화면을 보면서 시험한다면 무료로 업무에도 쓸 수 있는 LM Studio가 맞습니다. 명령어로 돌린다면 Ollama입니다. 둘 다 2026년 10월 26일에 공식 페이지를 확인했습니다.
Meta의 최신 모델을 시험한다면
Muse Spark Open은 Hugging Face에서 가중치가 배포됩니다. Meta의 페이지는 Apple M5 Ultra를 탑재한 Mac Studio 2대(각각 최대 512GB 메모리)로 돌리는 예를 들고 있습니다. TechCrunch는 Engadget을 인용해, 손안에서 돌리려면 최소 1테라바이트의 메모리가 필요하다고 전했습니다. 개인이나 작은 회사가 자기 컴퓨터에서 돌리는 모델이 아닙니다. Meta는 Amazon SageMaker AI, Google Cloud Model Garden, Microsoft Foundry Models와 Together AI, OpenRouter 등의 API로 쓸 수 있다고 안내합니다. Muse Glimmer는 노트북에서 돌리는 것을 목표로 한 소형판입니다.
히카리짱의 정리먼저 작은 모델을 LM Studio나 Ollama로 시험하는 것이 가장 손쉬워요. 큰 모델은 클라우드 서비스를 거쳐 쓰는 것을 전제로 생각하세요.
「오픈」이라는 말을 읽는 법: 업무용으로 고를 때의 확인점
Llama 3.1 발표로부터 2년 남짓, Meta는 「오픈」의 내용을 계속 바꿨습니다. 이름은 Llama에서 Muse로, 라이선스는 Llama의 것에서 Muse의 것으로 달라졌습니다. AI 모델을 업무에 들일 때는 「오픈이라고 쓰여 있다」가 아니라 다음 네 가지를 직접 확인하고 있습니다.
- 라이선스 이름을 본다. Apache 2.0이나 MIT처럼 널리 알려진 것인지, 회사가 독자적으로 만든 것인지. 독자적인 것은 조건을 전부 읽는다.
- 가중치를 손안에 저장한다. 내려받은 버전은 제공처가 방침을 바꿔도 계속 쓸 수 있다. 다만 그 라이선스의 조건은 지킨다.
- 한국어로 시험한다. 공식 지원 언어에 한국어가 없는 모델도 있다. 내 문장으로 품질을 확인한다.
- 갈아탈 수 있는 형태로 둔다. 특정 모델 이름에 업무를 지나치게 맞추지 말고, 다른 모델로 바꿀 수 있게 해 둔다.
클라우드 AI와의 구분은 ChatGPT 모델 차이 글이 참고가 됩니다.
히카리짱의 정리「오픈」이라고 쓰여 있어도 내용은 회사마다 달라요. 라이선스와 한국어 품질을 직접 확인한 뒤에 고르세요.
Llama 3.1에 대한 자주 묻는 질문
Llama 3.1은 지금도 쓸 수 있나요?
쓸 수 있습니다. Meta는 2026년 4월 현재의 Llama 모델은 계속 이용할 수 있다고 밝혔습니다. Ollama 등에서도 배포되고 있습니다.
Llama 3.1은 한국어를 지원하나요?
공식 지원 언어 8개에 한국어는 들어 있지 않습니다. 한국어 문서를 다룬다면 한국어를 공식 지원하는 모델과 비교해 보세요.
Llama는 상업적으로 쓸 수 있나요?
Llama 3.1 라이선스의 범위에서 쓸 수 있습니다. 월간 이용자 7억 명 조건, 「Built with Llama」 표시, 이름 붙이는 법, 이용 규정에 주의하세요.
Llama는 오픈소스가 아닌가요?
OSI는 Llama의 라이선스가 OSI 정의를 충족하지 않는다고 봅니다. 가중치는 공개되어 있으므로 「오픈 웨이트」라고 부르는 것이 정확합니다.
SOURCES
- Meta 「Introducing Llama 3.1」(2024년 7월 23일, 2026년 10월 26일 확인) ai.meta.com/blog/meta-llama-3-1
- Meta 「Llama 3.1 모델 카드」(2026년 10월 26일 확인) github.com/meta-llama/llama-models(MODEL_CARD)
- Meta 「Llama 3.1 Community License」(2024년 7월 23일 자, 2026년 10월 26일 확인) github.com/meta-llama/llama-models(LICENSE)
- SD Times 「Meta's new Llama 3.1 model competes with GPT-4o and Claude 3.5 Sonnet」(2024년 7월) sdtimes.com
- Open Source Initiative 「Meta's LLaMa license is still not Open Source」(2025년 2월 18일, 2026년 10월 26일 확인) opensource.org
- Open Source Initiative 「The Open Source AI Definition 1.0」(2026년 10월 26일 확인) opensource.org/ai/open-source-ai-definition
- GIGAZINE 「OSAID version 1.0 ... Meta's Llama does not meet open source AI standards」(2024년 10월 30일, 영어판) gigazine.net
- Meta 「The Llama 4 herd」(2025년 4월 5일, 2026년 10월 26일 확인) ai.meta.com/blog/llama-4-multimodal-intelligence
- The Decoder 「Meta releases first multimodal Llama 4 models, leaves EU out in the cold」(2025년 4월) the-decoder.com
- VentureBeat 「Goodbye, Llama? Meta launches new proprietary AI model Muse Spark」(2026년 4월 8일) venturebeat.com
- DeepLearning.AI 「With Muse Spark, Meta pivots away from its open-weights Llama strategy」(2026년 4월 17일) deeplearning.ai
- Yahoo Finance 「Meta launches new open-weight AI models ...」(2026년 8월 11일) finance.yahoo.com
- Meta Research 「Introducing Muse Spark Open」(2026년 10월 15일, 2026년 10월 26일 확인) research.meta.ai/blog/muse-spark-open
- TechCrunch 「Meta launches an open-weight model that runs on Macs」(2026년 10월 15일) techcrunch.com
- Ollama 「llama3.1」 라이브러리(2026년 10월 26일 확인) ollama.com/library/llama3.1
- Swallow LLM 「Llama 3.1 Swallow」(일본어, 2026년 10월 26일 확인) swallow-llm.github.io
- Impress Watch 「OpenAI、オープンウェイトのAIモデル「gpt-oss」を公開」(일본어, 2025년 8월 6일) watch.impress.co.jp/docs/news/2037179.html
- 9to5Google 「Google Gemma 4」(2026년 4월 2일) 9to5google.com
- Qwen 「Qwen3」 공식 블로그 qwenlm.github.io/blog/qwen3
- LM Studio 「LM Studio is free for use at work」(2025년 7월 8일) lmstudio.ai/blog/free-for-work
- LG AI Research 「LG AI Research Unveils K-EXAONE 2.0」(2026년 7월 31일, 2026년 10월 26일 확인) lgresearch.ai/news/view?seq=678
- 네이버 보도자료 「HyperCLOVA X SEED」 경량 모델 오픈소스 공개(2025년 4월) navercorp.com/media/pressReleasesDetail?seq=32475
- 뉴스서울 「과학기술정보통신부, 1월 22일부터 'AI기본법' 시행」(2026년 1월) newsseoul.co.kr
「HowtoAI」는 2024년부터 multifverse.com 에서 일본어로 이어 온 AI 활용 해설 시리즈입니다. 저희 회사 사명이 따뜻한기술(ATATAKAI Digital)로 바뀌어서, 2026년 10월부터 블로그의 한 카테고리로 이어 갑니다. 계속해서 많은 관심과 사랑 부탁드립니다.
AI 모델을, 어떤 일에 어떻게 고를까.
클라우드 AI와 내 컴퓨터에서 돌리는 오픈 웨이트 모델을 어떻게 나눠 쓸지. 라이선스와 다루는 데이터에 맞춰 함께 생각합니다.
따뜻한기술에 상담하기
최종 수정 2026년 10월 26일